
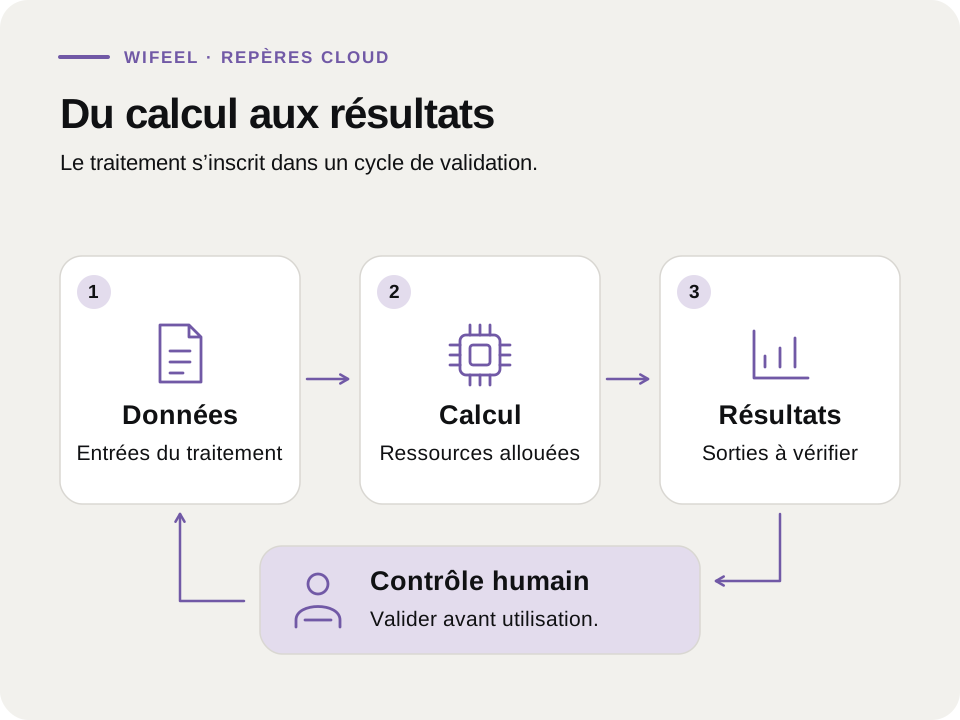
Comment organiser les objets d’un pipeline IA ?
Conservez les données brutes séparément des jeux transformés et des artefacts de modèle. Une expérience doit retrouver la version des données, le code de préparation et les paramètres utilisés. Sans ces références, comparer deux résultats devient difficile, même si les fichiers sont tous conservés.
Utilisez une convention de nommage stable et un manifeste indiquant les objets attendus. Prévoyez aussi ce qui peut être supprimé : fichiers temporaires, expériences abandonnées et doublons. Les données contenant des informations personnelles exigent une politique distincte des jeux de test publics.
Quelles performances mesurer avant le calcul ?
Mesurez le temps nécessaire pour charger un jeu représentatif et écrire un checkpoint. De nombreux petits objets et quelques fichiers volumineux ne sollicitent pas la plateforme de la même façon. La bande passante et la distance entre stockage et calcul peuvent limiter le débit.
Un essai utile reproduit la taille des objets et le nombre de lecteurs simultanés. Notez le temps de démarrage, les reprises après erreur et l’effet d’un cache local. Ne déduisez pas la performance de votre entraînement d’une affirmation générale publiée par le fournisseur.
Comment limiter les accès aux données sensibles ?
Attribuez des identifiants séparés aux étapes de préparation, d’entraînement et de consultation. Une tâche qui lit un jeu validé n’a pas nécessairement besoin de supprimer les données sources. Évitez de placer les secrets d’accès dans les notebooks partagés ou les fichiers de configuration publiés.
La région du stockage ne suffit pas à décrire le traitement. Vérifiez également où le calcul fonctionne, quels services reçoivent les entrées et combien de temps ils les conservent. Les embeddings et certains résultats peuvent encore contenir des données personnelles ou confidentielles.
Comment évaluer le coût du projet ?
Additionnez le stockage, la préparation, le calcul et les outils qui orchestrent le pipeline. Impossible Cloud annonce un stockage sans frais de sortie ni de requêtes API, sous ses conditions. Cela ne rend pas les GPU, les logiciels ou votre connexion gratuits.
Pour un projet porté avec WiFeel, décrivez d’abord les volumes et le traitement envisagé. Les offres de calcul et d’inférence de la plateforme doivent être vérifiées séparément, notamment leur disponibilité, leurs modèles et leur cadre contractuel. Aucun résultat ni délai d’entraînement n’est garanti par le seul choix du stockage.
Questions fréquentes
Le stockage objet fournit-il un modèle IA ?
Non. Il conserve les fichiers utilisés ou produits par un traitement. Le modèle, le moteur d’inférence et le calcul sont d’autres composants, avec leurs propres conditions d’accès et de facturation.
Faut-il tout conserver indéfiniment ?
Non. Une politique de conservation doit distinguer données sources, preuves de reproductibilité et fichiers temporaires. Les contraintes métier et les obligations sur les données personnelles guident les durées.
Sources et périmètre
Les caractéristiques de la plateforme sont attribuées à Impossible Cloud. Les tarifs et le périmètre d’accompagnement WiFeel sont précisés dans une proposition adaptée au projet.